IT之家 9 月 22 日消息,在昨日的 2026 人工智能计算大会(AICC2026)上,浪潮信息宣布推出元脑 SD200 Ultra 超节点 AI 服务器与元脑 HC2000 多元算力机组。
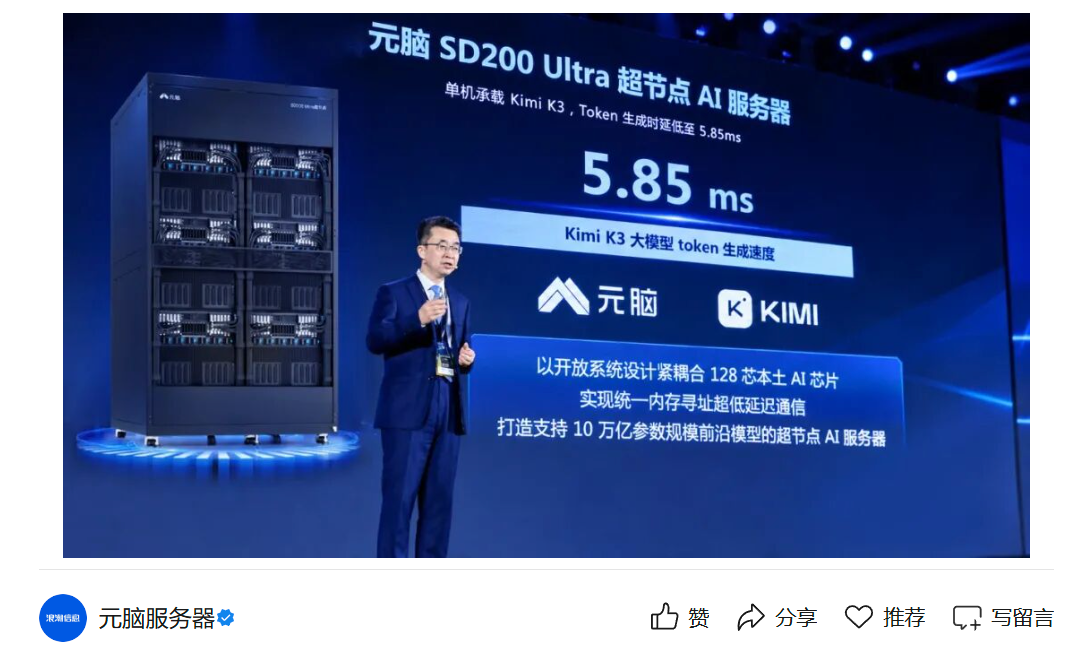
据官方介绍,元脑 SD200 Ultra 基于国产 AI 芯片打造,单机可承载运行 2.8 万亿参数的 Kimi K3 大模型。
浪潮表示,SD200 Ultra 的 Token 生成时延首次降至 5.85 毫秒以内,相当于单用户速度 170 Tokens/s,达到业界平均水平的 5 倍。该机型支持 10 万亿参数规模前沿模型单机运行。
IT之家注:Token 生成时延指大模型每输出一个词元所需的平均时间,是衡量推理响应速度的核心指标之一。
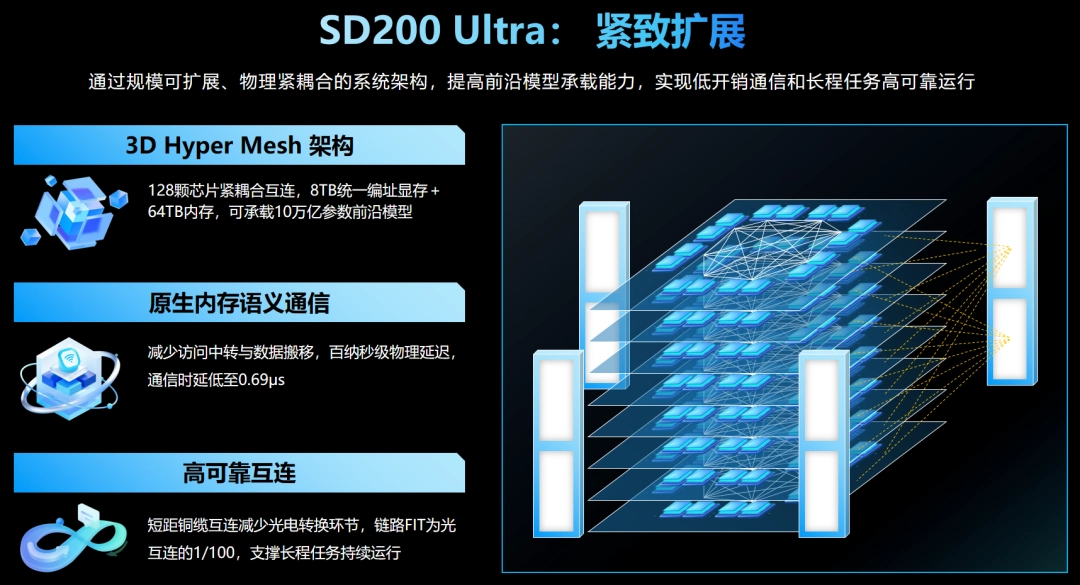
SD200 Ultra 采用 3D Hyper Mesh 架构,紧耦合 128 芯本土 AI 芯片,提供 8TB 统一编址显存和 64TB 内存。系统采用原生内存语义通信,通信时延低至 0.69 微秒。
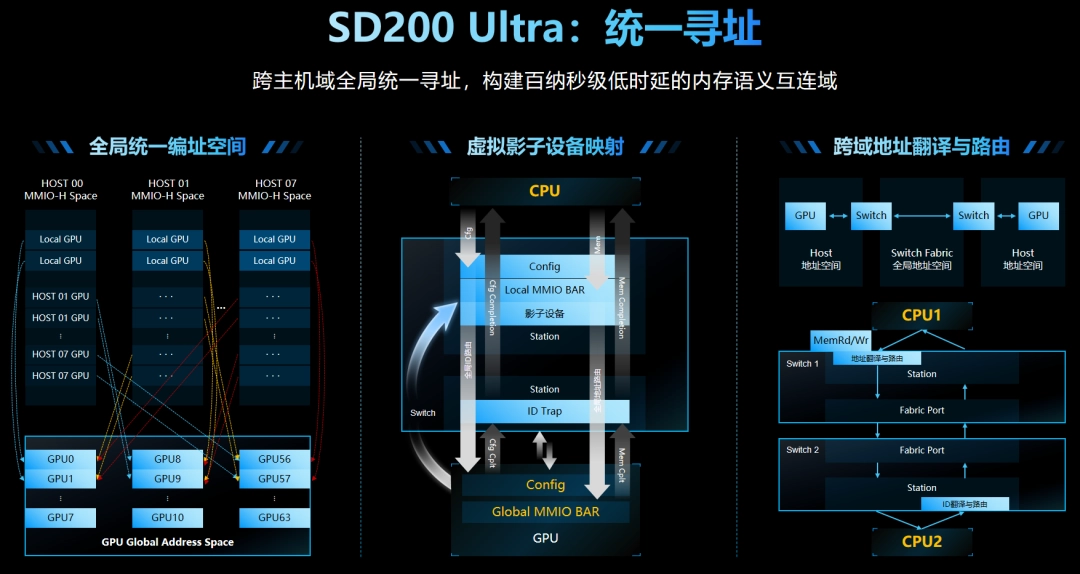
该超节点通过全局统一编址、虚拟影子设备映射、跨域地址翻译与路由,实现 GPU 跨主机域的统一寻址访问,构建百纳秒级低时延内存语义互连域。
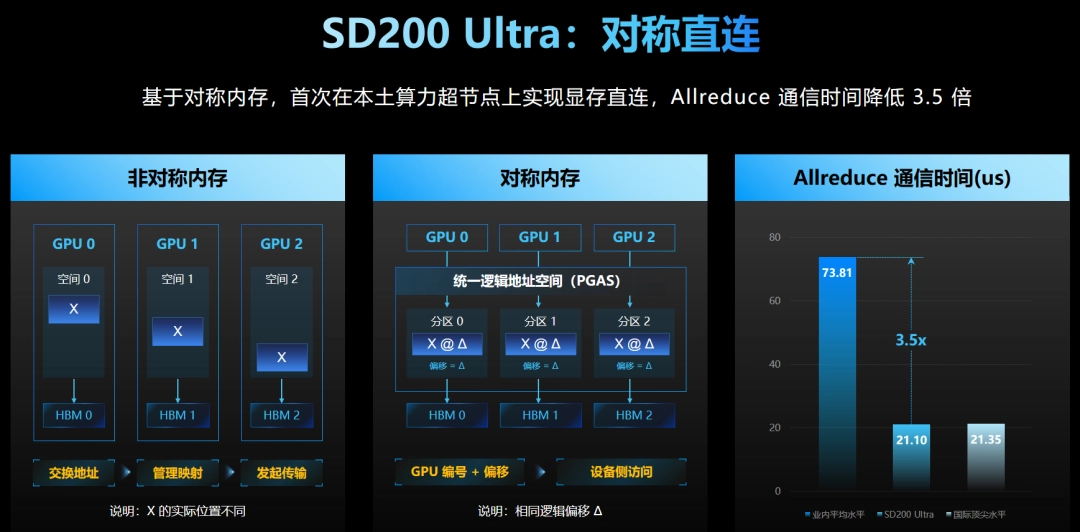
浪潮称,借助对称内存技术,SD200 Ultra 首次在基于本土 AI 芯片的超节点上实现 GPU 显存直连,使 GPU 可直接访问远端 GPU 显存。AllReduce 通信时间降低 3.5 倍。
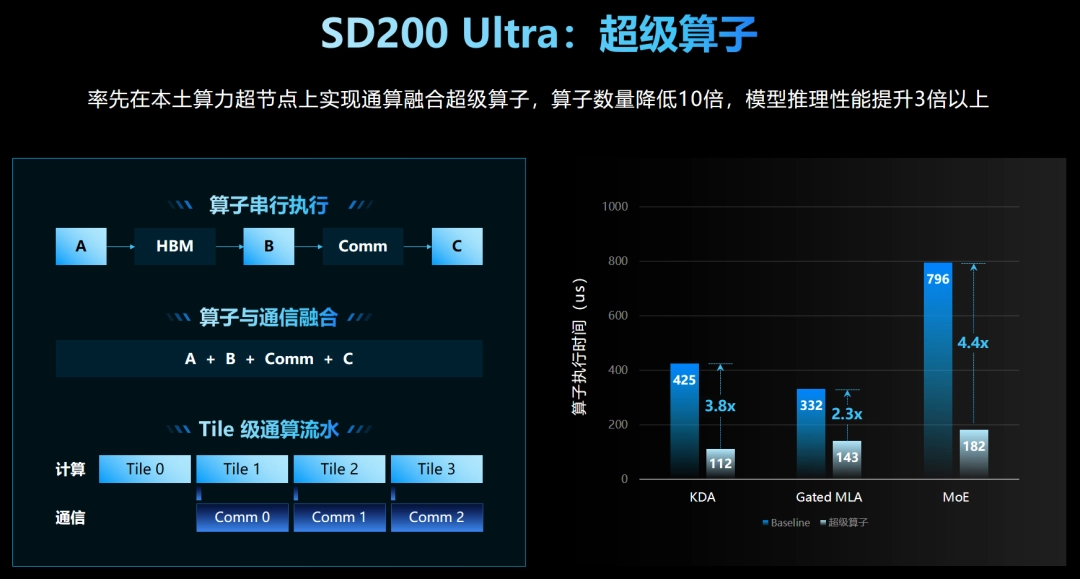
针对 Kimi K3 推理,SD200 Ultra 使用 Kimi K3 构建超级算子智能体,实现通算融合、Tile 级流水的超级算子,将 KDA、Gated MLA、MoE 中的基础算子融合。算子数量降低 10 倍,推理性能提升 3 倍以上。
浪潮同日发布元脑 HC2000 多元算力机组。该机组采用 DirectCom 2.0 极速架构,基于高密液冷 AI 整机柜,搭配 MCIS 推理软件栈,可动态匹配计算负载。官方称同等投资下 Token 产能提升 10 倍。
浪潮将 Agent 时代 AI 计算分为两个方向:Capability AI Compute 能力型智算,支撑突破智能上限;Capacity AI Compute 容量型智算,实现智能充分供给。
浪潮称,前沿模型参数规模已从 DeepSeek R1 的 6710 亿增长到 Kimi K3 的 2.8 万亿,并走向 10 万亿级;上下文从 128K 扩展到 1M 以上;Agent 从单体走向成百上千个协同。
模型权重、KV Cache(键值缓存,用于存储注意力机制中的键和值,减少重复计算)和并发任务规模同步增长,对显存容量、高速互连和并行扩展效率提出更高要求。
复杂 Agent 任务包含大量“推理 — 工具调用 — 反馈 — 重新规划”循环,每轮时延都会累积。浪潮信息称,时延已不只是体验指标,可能影响任务能否及时完成。
复杂 Agent 任务需连续运行数小时甚至数天,期间经历大量模型调用、工具调用和数据交互。任何计算、通信或软件故障都可能中断任务。